
Motor del Workflow - Funcionamiento General
1. Que es un Workflow
Sección titulada «1. Que es un Workflow»Un workflow es una secuencia de nodos conectados que procesan datos de forma ordenada. Cada nodo realiza una acción especifica (llamada HTTP, decision lógica, transformación de datos, consulta SQL, envío de correo, etc.) y pasa el resultado al siguiente nodo en la cadena.
El flujo de ejecución es dirigido: los datos entran por un nodo inicial (trigger), se transforman y enriquecen a medida que pasan por cada nodo, y finalmente alcanzan un nodo terminal o se detienen por una condición especifica.
Los workflows permiten automatizar procesos de negocio sin necesidad de escribir código, conectando modulos predefinidos mediante una interfaz visual de editor.
2. Arquitectura del Motor
Sección titulada «2. Arquitectura del Motor»El motor utiliza un modelo de ejecución basado en cola (queue-based execution). El proceso general es el siguiente:
Punto de entrada
Sección titulada «Punto de entrada»La función principal es:
processWorkflowV1(workflowName, workflowId, queryParams, webHook)Parámetros:
- workflowName: Nombre identificador del workflow a ejecutar.
- workflowId: Identificador único de la ejecución. Si no se proporciona, se genera automáticamente.
- queryParams: Parámetros iniciales que se inyectan como datos de entrada.
- webHook: Objeto de respuesta HTTP (cuando el workflow se inicia por webhook).
Secuencia de inicialización
Sección titulada «Secuencia de inicialización»- Carga de la definición: Se consulta la tabla
workflowsy se obtiene la columnaworkflow_json, que contiene toda la estructura del workflow (nodos, conexiones, configuraciones). - Generación de workflowId: Se genera un identificador único (UUID) para esta ejecución particular, permitiendo rastrear cada ejecución de forma independiente.
- Carga de variables de memoria: Se consulta la tabla
memorystoragepara obtener las variables persistentes asociadas al workflow. - Inicialización del contexto de ejecución: Se construye un objeto de contexto que incluye el mapeo de
nodeLabels(etiquetas legibles de cada nodo), el historial de pasos (steps), las variables de memoria y elworkflowId.
3. Flujo de datos entre nodos
Sección titulada «3. Flujo de datos entre nodos»Cada modulo (nodo) recibe tres argumentos y devuelve un objeto con el resultado:
Entrada del modulo
Sección titulada «Entrada del modulo»modulo(data, config, context)- data: La salida del nodo anterior. Es el dato principal que el nodo actual debe procesar. En el caso del primer nodo, corresponde a los datos iniciales del trigger.
- config: La configuración del nodo. Contiene los parámetros definidos por el usuario en el editor visual (por ejemplo, la URL de una petición HTTP, la consulta SQL, las condiciones de una decision, etc.).
- context: El contexto de ejecución. Incluye:
workflowId: Identificador único de esta ejecución.steps: Array con el historial acumulado de ejecución (resultados de nodos anteriores).nodeLabels: Mapeo de identificadores de nodos a sus etiquetas legibles.memoryVariables: Variables persistentes cargadas desdememorystorage.
Salida del modulo
Sección titulada «Salida del modulo»{ nextModule: "id_del_siguiente_nodo", // o array, o null data: { ... }, // datos de salida error: null, // objeto de error si fallo _meta_: { ... } // metadatos opcionales}- nextModule: Determina que nodo se ejecuta a continuación.
- data: Los datos de salida que se convierten en la entrada del siguiente nodo.
- error: Objeto de error en caso de fallo (null si fue exitoso).
- meta: Metadatos opcionales del modulo (tiempo de ejecución, flags, etc.).
4. Bucle principal de ejecución
Sección titulada «4. Bucle principal de ejecución»El motor utiliza una cola FIFO (First In, First Out) llamada moduleQueue para gestionar el orden de ejecución de los nodos.
Algoritmo del bucle
Sección titulada «Algoritmo del bucle»1. Inicializar moduleQueue con el nodo de inicio (start)2. Mientras moduleQueue no este vacia: a. Tomar el siguiente elemento de la cola b. Resolver variables dinamicas en la configuracion del nodo c. Cargar el codigo del modulo correspondiente al tipo de nodo d. Ejecutar el modulo con (data, config, context) e. Almacenar el resultado en la tabla workflowstates f. Agregar el resultado al array de steps del contexto g. Determinar el/los siguiente(s) modulo(s) h. Insertar el/los siguiente(s) modulo(s) en la cola3. Fin de la ejecucionResolución de variables dinámicas
Sección titulada «Resolución de variables dinámicas»Antes de ejecutar cada nodo, el motor resuelve las variables dinámicas presentes en la configuración. Estas variables permiten referenciar datos de nodos anteriores o variables de memoria. El formato tipico es {{nombreVariable}} o referencias a pasos previos como {{steps.nodo_anterior.campo}}.
Almacenamiento de estado
Sección titulada «Almacenamiento de estado»Tras cada ejecución de nodo, el resultado se persiste en la tabla workflowstates con información como:
- Identificador del workflow y del nodo
- Estado de ejecución (success, error)
- Datos de entrada y salida
- Tiempo de respuesta en milisegundos
5. Resolución de nodos siguientes
Sección titulada «5. Resolución de nodos siguientes»El valor de nextModule retornado por cada nodo determina como continua el flujo:
Flujo lineal (nextModule es un string)
Sección titulada «Flujo lineal (nextModule es un string)»El nodo devuelve un único identificador. La ejecución continua de forma secuencial al nodo indicado.
nextModule: "http_2"Ramas paralelas (nextModule es un array)
Sección titulada «Ramas paralelas (nextModule es un array)»El nodo devuelve múltiples identificadores. Cada uno se agrega a la cola y se ejecutan en orden.
nextModule: ["rama_a_1", "rama_b_1"]Nodos de decision (truePath / falsePath)
Sección titulada «Nodos de decision (truePath / falsePath)»Los nodos de tipo decision evaluan una condición y retornan la ruta correspondiente:
- Si la condición es verdadera: sigue por
truePath - Si la condición es falsa: sigue por
falsePath
nextModule: condicion ? config.truePath : config.falsePathFin de rama (nextModule es null)
Sección titulada «Fin de rama (nextModule es null)»Cuando nextModule es null, la rama actual termina. Si hay otros elementos en la cola, la ejecución continua con ellos.
nextModule: nullDetención del workflow (_stopflowprocess)
Sección titulada «Detención del workflow (_stopflowprocess)»Cuando un nodo retorna el flag _stopflowprocess, se detiene completamente la ejecución del workflow y se retorna la respuesta HTTP al cliente. Este flag se usa para workflows iniciados por webhook que necesitan responder inmediatamente.
6. Estructura del Workflow JSON
Sección titulada «6. Estructura del Workflow JSON»La definición de un workflow se almacena como JSON en la columna workflow_json de la tabla workflows. La estructura general es la siguiente:
{ "id": "123", "name": "mi_workflow", "start": "start_1", "active_schedule": true, "schedule": "0 9 * * *", "modules": { "start_1": { "type": "start", "config": { "label": "Inicio", "nextModule": "http_2" } }, "http_2": { "type": "http", "config": { "label": "Consultar API", "method": "GET", "url": "https://api.ejemplo.com/datos", "headers": {}, "nextModule": "decision_3" } }, "decision_3": { "type": "decision", "config": { "label": "Verificar resultado", "conditions": [], "truePath": "mail_4", "falsePath": "end_5" } }, "mail_4": { "type": "sendmail", "config": { "label": "Enviar notificacion", "to": "admin@ejemplo.com", "subject": "Resultado", "nextModule": "end_5" } }, "end_5": { "type": "end", "config": { "label": "Fin" } } }}Campos principales
Sección titulada «Campos principales»| Campo | Descripción |
|---|---|
id | Identificador único del workflow |
name | Nombre del workflow (usado como referencia en la URL o programación) |
start | Identificador del nodo inicial |
active_schedule | Si el workflow tiene programación activa (true/false) |
schedule | Expresion cron para ejecución programada |
modules | Objeto con todos los nodos del workflow, indexados por su identificador |
Campos de cada modulo
Sección titulada «Campos de cada modulo»| Campo | Descripción |
|---|---|
type | Tipo de modulo (start, http, decision, sendmail, sql, etc.) |
config | Configuración especifica del modulo |
config.label | Etiqueta visible del nodo en el editor |
config.nextModule | Siguiente nodo a ejecutar |
7. Control de errores
Sección titulada «7. Control de errores»El motor implementa varios mecanismos para gestionar errores durante la ejecución.
Reintentos automáticos
Sección titulada «Reintentos automáticos»Por defecto, cada nodo tiene hasta 3 reintentos en caso de fallo. El motor reintenta la ejecución del nodo antes de marcarlo como fallido definitivamente.
Flag continueOnError
Sección titulada «Flag continueOnError»Cuando un nodo tiene activado el flag continueOnError, la ejecución del workflow continua al siguiente nodo aunque el nodo actual haya fallado. Esto es útil para nodos no criticos donde un fallo no debe detener todo el proceso.
Tipos de error
Sección titulada «Tipos de error»| Tipo de error | Descripción |
|---|---|
EMPTY_INPUT_DATA | El nodo recibio datos de entrada vacios o nulos |
EMPTY_RETURN_DATA | El nodo no devolvio datos de salida |
UNKNOWN_ERROR | Error no clasificado o inesperado |
Registro de errores
Sección titulada «Registro de errores»Todos los errores se registran en la tabla workflowstates junto con:
- El tipo de error
- El mensaje descriptivo
- Los datos de entrada que causaron el fallo
- El timestamp de la ocurrencia
Esto permite diagnosticar problemas revisando el historial de ejecución de cada nodo.
8. Seguimiento y trazas
Sección titulada «8. Seguimiento y trazas»El motor proporciona dos mecanismos de seguimiento para monitorear y depurar las ejecuciones.
Tabla workflowstates
Sección titulada «Tabla workflowstates»Registra la ejecución de cada nodo individual. Cada fila contiene:
| Campo | Descripción |
|---|---|
workflow_id | Identificador único de la ejecución |
node_id | Identificador del nodo ejecutado |
status | Estado de la ejecución (success, error) |
data | Datos de salida del nodo |
response_time_ms | Tiempo de ejecución del nodo en milisegundos |
created_at | Fecha y hora de la ejecución |
Tabla workflow_traces
Sección titulada «Tabla workflow_traces»Almacena trazas detalladas con diferentes niveles de severidad:
| Nivel | Uso |
|---|---|
TRACE | Información de bajo nivel, flujo detallado de ejecución |
INFO | Eventos informativos generales |
WARN | Advertencias que no detienen la ejecución |
ERROR | Errores que afectan la ejecución del nodo o workflow |
DEBUG | Información de depuración para desarrollo |
Array de steps
Sección titulada «Array de steps»Durante la ejecución, el contexto mantiene un array steps que acumula el resultado de cada nodo ejecutado. Este array esta disponible para todos los nodos posteriores, permitiendo acceder a datos de cualquier nodo anterior en el flujo.
context.steps = [ { nodeId: "start_1", data: { ... }, status: "success" }, { nodeId: "http_2", data: { ... }, status: "success" }, // ... mas pasos]9. Flags especiales de control de flujo
Sección titulada «9. Flags especiales de control de flujo»El motor reconoce varios flags especiales que alteran el comportamiento normal de la ejecución.
_stopflowprocess
Sección titulada «_stopflowprocess»Detiene completamente la ejecución del workflow y retorna una respuesta HTTP al cliente. Se usa principalmente en workflows iniciados por webhook donde se necesita enviar una respuesta inmediata.
{ nextModule: null, data: { resultado: "ok" }, _stopflowprocess: true}Cuando este flag esta activo, la cola de ejecución se vacía y los datos del nodo se envian como respuesta HTTP.
_respondata
Sección titulada «_respondata»Permite enviar una respuesta al cliente HTTP sin detener la ejecución del workflow. El workflow continua procesando en segundo plano mientras el cliente ya recibio su respuesta.
{ nextModule: "siguiente_nodo", data: { ... }, _respondata: { mensaje: "Recibido, procesando..." }}_iterating
Sección titulada «_iterating»Indica que el nodo actual esta en modo de iteración por lotes. El motor ejecuta el mismo nodo (o subconjunto de nodos) múltiples veces, una vez por cada elemento de un array de datos.
_batchSteps
Sección titulada «_batchSteps»Contiene los resultados acumulados de cada iteración cuando se usa el modo de iteración por lotes. Al finalizar todas las iteraciones, este array se pasa al nodo merge para consolidar los resultados.
{ _batchSteps: [ { iteration: 0, data: { ... } }, { iteration: 1, data: { ... } }, // ... una entrada por cada elemento iterado ]}10. Diagrama de flujo
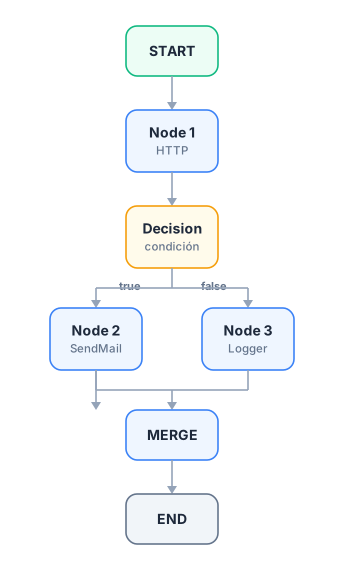
Sección titulada «10. Diagrama de flujo»El siguiente diagrama ASCII muestra un ejemplo tipico de ejecución de un workflow con decision:
Descripción del flujo
Sección titulada «Descripción del flujo»- START: El trigger inicia la ejecución y proporciona los datos iniciales.
- Node 1 (HTTP): Realiza una petición HTTP a una API externa y pasa la respuesta al siguiente nodo.
- Decision: Evalua una condición sobre los datos recibidos. Si es verdadera, continua por la rama izquierda (true); si es falsa, por la derecha (false).
- Node 2 (SendMail): Envia un correo electronico con los datos obtenidos.
- Node 3 (Logger): Registra los datos para auditoria.
- MERGE: Consolida las ramas paralelas en un único flujo.
- END: Finaliza la ejecución del workflow.